Il livello di rete e quello di trasporto si occupano di trasferire i bits da un host all'altro, ma chi decide cosa, quando e dove trasferire certe informazioni, nonché il loro significato, è il livello Applicazione. Nonostante il sistema dei protocolli Internet è in grado di stabilire un servizio di comunicazione, essi non possono iniziare il contatto, o accettarlo, con un computer remoto. Alla comunicazione devono comunque partecipare due software applicativi che interagiscono secondo lo schema client/server. Ciascun programma applicativo, inoltre, è collegato con uno dei protocolli del livello trasporto per inviare o ricevere dati, a cui passa i dati nella forma richiesta. In altre parole nel livello Applicazione viene svolto unicamente il lavoro più "vicino" all'utente, ovvero si gestisce l'interattività tra l'utente e la macchina.
Il servizio che un'applicazione richiede al livello trasporto può essere di varia natura. In generale gli aspetti su cui si possono basare richieste particolareggiate sono:
La tabella seguente fornisce un quadro riassuntivo delle caratteristiche richieste dalle principali classi di applicazioni:
| Applicazione | Perdita dati | Larghezza banda | Sensibilità ai ritardi |
| Pagina web | ammissibile | elastica | no |
| Trasmissione audio/video in tempo reale | ammissibile | audio > 5Kbps, video > 10 Kbps |
si, 100 msec |
| Trasmissione audio/video memorizzata | ammissibile | audio > 5Kbps, video > 10 Kbps |
si, pochi sec |
| Gioco interattivo | ammissibile | qualche Kbps up | si, 100 msec |
| Pagina finanziaria | nessuna | elastica | dipende |
| Trasferimento file | nessuna | elastica | no |
| Posta elettronica | nessuna | elastica | no |
E dunque i protocolli di trasporto utilizzati sono:
| Applicazione | Protocollo di livello trasporto |
| Pagina web | TCP |
| Streaming multimedia (protocolli proprietari) | TCP o UDP |
| Telefonia Internet (protocolli proprietari) | UDP |
| Trasferimento file | TCP |
| Accesso remoto | TCP |
| Posta elettronica | TCP |
Nel livello Applicazione sono presenti diverse tipologie di oggetti software:
Nel seguito approfondiremo il funzionamento di alcuni di questi protocolli, con riferimento alla specifica tipologia di servizio che offrono.
Il protocollo DNS (Domain Name System) consente di riferirsi ad una risorsa utilizzando un nome logico, costituito da una stringa di caratteri alfanumerica, piuttosto che utilizzando direttamente l'indirizzo IP, scomodo da ricordare. Il ruolo del DNS permette proprio la creazione di una corrispondenza tra un indirizzo IP e una stringa di caratteri attraverso l'uso di computer di servizio, detti name server o DNS server, interpellati per ogni traduzione da un "indirizzo DNS" ad un indirizzo IP.
Questo sistema di assegnazione dei nomi si compone logicamente dei seguenti aspetti:
Il funzionamento di massima è il seguente:
Il sistema di nominazione DNS permette di creare uno spazio di nomi gerarchico, basato su differenti livelli di dominio. I livelli gerarchicamente più alti, sono chiamati domini di primo livello (TLD o Top Level Domain). Lo schema logico dei nomi si compone dunque di varie parti, o sottodomini, con l'indicazione fino al dominio di primo livello cui appartengono:
" nome_macchina.dominio_3_livello.dominio_2_livello.dominio_1_livello "
in cui la prima sottostringa "nome_macchina" identifica il nome dell'host, le sottostringhe successive identificano sottodomini dei domini identificati dalle stringhe seguenti, l'ultima sottostringa identifica il TLD.
I domini di primo livello sono molteplici. Alcuni di essi, di tipo organizzativo, raggruppano gli enti/istituzioni in base al loro tipo di attività (inizialmente nati solo per le istituzioni statunitensi), altri, di tipo nazionale, riguardano tutti gli stati esistenti al mondo.
| Alcuni domini di tipo organizzativo | Alcuni domini di tipo nazionale | ||
| com | Enti commerciali | it | Italia |
| gov | Istituzioni governative | ca | Canada |
| edu | Istituzioni accademiche | de | Germania |
| net | Organizzazioni di servizio in rete | fr | Francia |
| org | Organizzazioni non-profit | uk | Regno Unito |
| mil | Istituzioni militari | es | Spagna |
| nom | Pagine personali | ru | Russia |
La registrazione dei domini organizzativi oggi è aperta alla concorrenza ed affidata all'ICANN (Corporation for Assigned Names and Numbers, http://www.icann.org/) assieme alla gestione dello spazio degli indirizzi IP.
Ogni dominio è responsabile della creazione dei suoi sottodomini, che sono registrati presso apposite autorità. In Italia l'ente responsabile è la Registration Authority Italiana (http://www.nic.it/RA/) che si occupa della gestione del name server primario del contry code italiano "it". Tale servizio è attivo su un server specificatamente dedicato a questo compito (dns.nic.it)
Esempi di sottodomini italiani sono: apav.it (Accademia Piceno Aprutina dei Velati), unite.it (Università degli Studi di Teramo), cnr.it (Consiglio Nazionale delle Ricerche), virgilio.it (Motore di ricerca), ecc.
L'estensione dei domini è indipendente da quella delle reti e delle sottoreti; inoltre, ciascun dominio è responsabile di fornire il servizio DNS al suo interno, cioé deve essere in grado di rispondere ad interrogazioni riguardanti sottodomini al suo interno.
Il servizio viene fornito, inoltre, in maniera distribuita. Ciascun name server (ogni ISP o ente ha un name server) conserva informazioni relative a :
Esempio. Supponiamo di voler accedere all'indirizzo pong.engr.orst.edu. La richiesta dell'indirizzo IP viene innanzitutto inviata al name server definito nella configurazione, che indica a quale name server è associato il dominio di primo livello edu. Quindi il nostro name server restituisce l'indirizzo IP del name server associato ad edu; questo server, ricevuta la richiesta, controlla a quale name server è associato il dominio di secondo livello orst.edu e fornisce il suo l'indirizzo IP per girare la richiesta. Il processo prosegue, di dominio in sottodominio, fino a raggiungere il name server responsabile di quel sottodominio che è in grado di restituire l'indirizzo IP della macchina pong che si trova all'interno del dominio engr.orst.edu.
I router che costituiscono le radici nella gerarchia dei server DNS, detti proprio root name servers, sono una dozzina a livello mondiale. Questi vengono contattati dai name server che non sono in grado di risolvere un nome DNS e si occupano di ottenere, attraverso il name server opportuno, l'indirizzo IP dell'host richiesto.
Una ulteriore semplificazione per il corretto funzionamento della rete prevede: la presenza di più name server per la gestione di un solo dominio, per evitare che il dominio diventi irraggiungibile dalla rete a seguito di guasti, la capacità del nostro name server di memorizzare in una sua cache gli indirizzi IP incontrati lungo il cammino (solo per un certo periodo di tempo, per lasciare l'opportunità di aggiornare gli indirizzi) e utilizzarli in future richieste, con la possibilità, in questo modo, di saltare vari livelli della procedura. Esiste, inoltre, la possibilità di definire degli alias che permettono di definire equivalenze fra nomi letterali e associazioni fra più nomi DNS ed un singolo computer, per concentrare una serie di servizi sullo stesso sullo stesso computer. Ad esempio, un'azienda può (come di solito accade) dislocare il proprio sito FTP, con nome ftp.azienda.it, ed il sito WWW, con nome www.azienda.it, sullo stesso computer con indirizzo DNS raff.azienda.aruba.it.
Il protocollo DHCP (Dynamic Host Configuration Protocol) permette la
configurazione dinamica di un host che si collega ad una rete IP. Costruito sul
modello client/server, esso prevede la presenza di un server DHCP, che non
possiede informazioni esatte sull'host e sulla sua configurazione in rete fino a
che questo non la richieda, e che implementa due meccanismi:
- la consegna dei parametri di configurazione specifici dell'host
- l'allocazione degli indirizzi di rete fra le macchine stesse.
Il pezzo d'informazione più significativo che viene scambiato fra l'host e il server DHCP è l'indirizzo IP. In generale l'allocazione permessa dal DHCP può essere automatica (se all'host è assegnato un indirizzo IP permanente) o dinamica (se l'indirizzo IP è assegnato al client per un limitato periodo di tempo). L'allocazione dinamica, in particolare, risulta particolarmente utile in quanto assegna un indirizzo ad un client solo temporaneamente, in relazione alla sua connessione alla rete e permette di dividere un numero limitato di indirizzi fra un gruppo di client che non hanno bisogno di un indirizzo IP permanente. In tal modo l'indirizzo assegnato può essere diverso ogni volta che l'host si connette alla rete. Molti Provider utilizzano l'indirizzamento dinamico per gli utenti che si connettono con il dial-up telefonico.
Il proposito alla base del protocollo è quello di ridurre il lavoro necessario per amministrare reti molto ampie.
Costituisce uno dei servizi più consolidati (è in uso da circa 20 anni) ed utilizzati di Internet. Con questo servizio il servizio postale per via elettronica è completamente organizzato e dispone le seguenti possibilità:
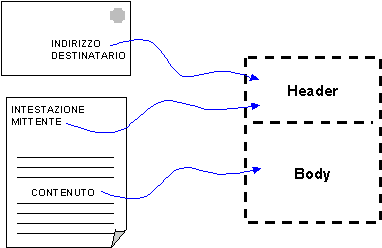
Un messaggio di posta elettronica ha un formato ben definito, costituito da una intestazione (header) e da un corpo (body), esattamente come avviene nella "cartacea" posta ordinaria:
Le informazioni contenute nell'header sono, in linea di massima,
le seguenti:
- indirizzo di ritorno del messaggio (Return Path o Reply-To)
- principali tappe nel percorso di consegna (Received)
- codice identificativo del messaggio (Message-ID)
- data e ora di invio del messaggio (Date)
- indirizzo del mittente (From)
- indirizzo del destinatario, anche molti (To)
- eventuale indirizzo del destinatario cui si invia il messaggio per conoscenza,
anche molti (Cc - Carbon Copy)
- eventuale indirizzo del destinatario "nascosto", anche molti (Bcc
- Blind Carbon Copy)
- soggetto del messaggio (Subject)
- eventuale codifica dei file non ASCII (Mime-Version, Content-Type)
- priorità del messaggio (X-Priority, X-MSMail-Priority)
- mail client (X-Mailer).
Il Body, invece, contiene il testo del messaggio. In ogni caso entrambe le parti, dunque sia header che body, devono essere espressi in linguaggio ASCII ridotto (a 7 bit), con eventuali codifiche aggiuntive per trasmettere caratteri o files non ASCII.
Gli indirizzi di posta elettronica hanno la forma:
nomeutente@nomehost
dove nomeutente (o username) è formato da una stringa di caratteri che identificano il destinatario, mentre nomehost è un nome DNS o un indirizzo IP. Ad esempio info@apav.it è l'indirizzo di posta elettronica di chi ha curato la realizzazione di queste dispense. In genere nomehost corrisponde ad un dominio e non ad un singolo host, al fine di rendere gli indirizzi indipendenti da eventuali variazioni sui nomi logici o sugli indirizzi IP degli host presenti nel dominio.
I protocolli SMTP e POP3. La posta elettronica è implementata attraverso la cooperazione di due tipi di sottinsiemi:
Mail User Agent (MUA), l'interfaccia tra l'utente e l'applicazione di rete, che permette di comporre i messaggi, consegnarli per la trasmissione, riceverli, leggerli, salvarli ed eliminarli
Mail Transport Agent (MTA), l'applicazione di rete vera e propria, che permette di trasportare i messaggi sulla rete fino al MTA di destinazione, consegnare la posta ai MUA.
Il MUA coincide con l'applicazione (software) per la lettura della posta elettronica sul computer locale, il cosiddetto mail reader (o mail client). Tra i più conosciuti figurano Microsoft Outlook (e sue varianti), Netscape Messenger ed Eudora (e sue varianti).
In corrispondenza delle funzionalità illustrate si utilizzano due protocolli distinti:
SMTP (Simple Mail Transfer Protocol), per il trasporto dei messaggi dal MUA d'origine fino ad un MTA e fra i vari MTA, da sorgente a destinazione
POP3 (Post Office Protocol versione 3), per la consegna del messaggio da un MTA al MUA di destinazione.
Gli ultimi protocolli introdotti, molto sofisticati, sono IMAP (Interactive Mail Access Protocol) e DMSP (Distributed Mail System Protocol).
Vediamo come avviene la trasmissione di un messaggio. Supponiamo che l'utente alice@meraviglie.wd spedisca un messaggio all'utente bella@bosco.wd
e che
- Alice usi un MUA configurato per consegnare la posta ad un SMTP server (in
figura: Server 1) in esecuzione sull'host mailer.meraviglie.wd
- Bella usi un MUA configurato per prelevare la posta da un POP3 server (in
figura: Server 2) in esecuzione sull'host mailer.bosco.wd.
La sequenza di operazioni è la seguente:
|
Fase iniziale: operazioni compiute da Alice e dal suo MUA |
|
|
Fase intermedia: operazioni compiute dai soli MTA |
|
In pratica, in queste prime due fasi, il messaggio viene depositato nella Mail Box (casella postale elettronica) di Bella:
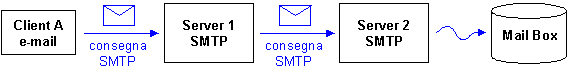
In generale la consegna del messaggio da mailer.meraviglie.wd a mailer.bosco.wd può non avvenire direttamente, bensì attraversando un certo numero di server SMTP intermedi
|
Fase finale: operazioni compiute da Bella e dal suo MUA |
|
In pratica, in quest'ultima fase, Bella legge il messaggio ricevuto dalla sua Mail Box:
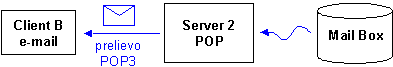
La risposta del DNS server all'interrogazione sull'indirizzo IP cui spedire la posta destinata al dominio del nostro esempio, avviene attraverso la conoscenza, nelle tabelle DNS, del fatto che tutta la posta destinata a bosco.wd deve essere consegnata all'host mailer.bosco.wd, informazione, questa, contenuta in speciali record MX (Mail Exchange):
| mailer.bosco.wd | A | 124.53.76.91 |
| bosco.wd | MX | mailer.bosco.wd |
Se il protocollo SMTP gestisce l'apertura della connessione, il trasferimento
delle informazioni e la chiusura della connessione, il protocollo POP3 gestisce
l'accesso remoto alle caselle di posta elettronica previa autenticazione degli
utenti. Caratteristiche salienti di quest'ultimo protocollo sono:
- possibilità di non mantenere una connessione persistente fra il client POP3
ed il server POP3
- prelievo dei messaggi dalla casella di posta con cancellazione degli stessi
dal server remoto e loro salvataggio sul computer locale.
Il protocollo IMAP. Il protocollo POP3 non permette un'efficiente gestione della posta nel caso di utenti che utilizzano più computer per accedere alle proprie caselle e-mail. In tal caso si rivela particolarmente utile un altro protocollo per la gestione della posta, ovvero IMAP (Interactive Mail Access Protocol). Questo protocollo consente l'accesso alle caselle di posta in maniera più sofisticata in quanto permette la lettura della posta e la sua manipolazione direttamente sul server ed inoltre non cancella nessun messaggio, se non dopo specifica richiesta dell'utente. In altre parole esso permette ad un software client di accedere ai messaggi remoti dal proprio calcolatore, proprio come se fossero locali, senza bisogno di trasferire i messaggi o i files tra questi computers.
L'utilizzo di questo protocollo consente di accedere alla posta da più calcolatori ed è pertanto molto importante in relazione alla crescita del fenomeno per cui ogni utente utilizza computer multipli (ufficio, casa, portatile, ecc.); il protocollo POP lavora invece meglio nel caso di utente con un solo calcolatore, in quanto le sue funzionalità permettono di accedere ai messaggi in modalità off-line.
Un esempio tipico di IMAP client è la Web Mail. Il funzionamento è il seguente:
Un altro esempio tipico di utilizzo del protocollo IMAP consiste nell'accesso alle bacheche elettroniche (bulletin board messages).
Il protocollo MIME. La possibilità di inviare file allegati (di qualunque tipo) con la posta elettronica, funzionalità ulteriore che la rende un mezzo di comunicazione molto potente, viene fornita attraverso il protocollo standard MIME (Multipurpose Internet Mail Extension).
Questo protocollo specifica come i messaggi o i files in essi contenuti, in aggiunta al testo ASCII di base, devono essere formattati per essere scambiati fra differenti sistemi di posta elettronica. Per assicurare la completa compatibilità tra i sistemi di posta di Internet (MIME o altro) i dati devono essere di tipo ASCII a 7-bit. Pertanto le specifiche MIME definiscono regole per convertire dati binari arbitrari nella codifica ASCII a 7-bit, con cui questi possono essere trasmessi attraverso Internet, e quindi riconvertiti nel formato originale senza perdite o corruzioni di dati.
Il protocollo MIME è molto flessibile, permettendo di includere
virtualmente ogni tipo di file o documento in un messaggio e-mail. Tipicamente, un messaggio MIME può contenere testo, immagini, audio,
video, o dati specifici di qualunque applicazione. La natura dei dati che
compongono il file viene specificata attraverso il campo Content-type, caratterizzato con l'assegnazione
tipo/sottotipo, ovvero del tipo di oggetto e del suo
sottotipo:
- tipo text, per dati di natura testuale (sottotipi plain, richtext,
enriched, ecc.);
- tipo image, per dati grafici (sottotipi jpeg, gif, g3fax,
ecc.); tipo audio (sottotipi basic, tone, ecc.);
- tipo video (sottotipi mpeg, quicktime, ecc.);
- tipo application, per dati processabili da particolari applicazioni o
semplicemente binari (sottotipi octet-stream, postscript, pdf,
msword, zip, vnd.ms-excel, vnd.ms-powerpoint,
ecc.);
- tipo multipart, per dati formati da un insieme di dati indipendenti, ad
esempio un testo con immagini (sottotipi mixed, alternative, parallel,
digest, ecc.);
- tipo message, per messaggi incapsulati (sottotipi rfc822, partial,
external-body, ecc.).
Esempio: il file esempio.ps viene codificato con il formato MIME application/postscript, mentre il file prova.jpg viene codificato con il formato MIME image/jpeg.
Per alcuni tipi di oggetti, inoltre, sono inoltre richieste informazioni ausiliarie, come l'insieme dei caratteri o charset (us-ascii, iso-8859-6, ecc.), oppure le conversioni utilizzate o content transfer encoding (base64, quoted-printable, ecc.).
Le mailing lists. Una mailing list (electronic mailing list) è una risorsa basata sull'e-mail che permette di condividere domande, risposte, informazioni e documenti con altri membri dello stesso gruppo, ovvero consente ad un gruppo di persone di comunicare tra di loro. Il servizio si basa su un indirizzo e-mail di gruppo e su un programma list server che mette in corrispondenza un indirizzo con una lista di indirizzi. Ciò avviene attraverso un meccanismo di exploder postale in cui si accetta un messaggio in arrivo o lo si invia ad un gran numero di destinatari. La procedura è sostanzialmente la seguente:
Il meccanismo è di fatto equivalente allo scambiarsi messaggi di posta in
cui il campo "A:" (ovvero "To:") contenga tutti gli
indirizzi e-mail dei componenti del gruppo, tuttavia le mailing list offrono
importanti vantaggi:
- la posta è spedita ad un solo indirizzo ma i mittenti sono tanti
- le persone possono facilmente associarsi o lasciare il gruppo
- i messaggi sono salvati in archivio.
Il World Wide Web (WWW, Web o W3), anche detta ragnatela mondiale, è un’architettura software che fornisce l’accesso e la navigazione ad un insieme di iperoggetti multimediali residenti fisicamente nelle memorie delle macchine collegate ad Internet.
Questi oggetti (tipicamente documenti e programmi), detti anche pagine web, sono pertanto collegati tra di loro in modo da formare un grande ipermedia, evoluzione del concetto di ipertesto, e contengono testo formattato con linguaggio specifico, collegamenti (link) ad altre pagine web o ad altre risorse; possono contenere però anche immagini, suoni, video, scenari tridimensionali e codice (script) eseguibile localmente.
Oggi il WWW rappresenta il servizio più famoso offerto da Internet, ma
nell’ultimo decennio è stata anche la ragione che ha decretato il suo
successo ed il suo enorme sviluppo. Ragioni più precise per comprendere il
rapido successo avuto dall’architettura WWW sono da ricercare in alcune
caratteristiche peculiari, quali:
- l’ampia scalabilità,
- la sua adattabilità alle reti,
- la sua natura distribuita e l’accessibilità da tutte le piattaforme,
- ma anche per lo standard di pubblico dominio su cui è basato.
L’architettura software è di tipo client/server. Il Web User Agent, ovvero l'interfaccia tra utente e protocollo di rete, è il cosiddetto Browser. Tra gli agenti browser più noti figurano Mosaic, l’antenato degli attuali browser, Netscape Navigator e Microsoft Internet Explorer (ciascuno con diverse versioni) ed Opera (e sue varianti). A tal proposito vale la pena ricordare la cosiddetta “guerra dei browser”, cui le maggiori case produttrici hanno dato vita nella seconda metà degli anni ’90, per affermare e/o difendere la propria posizione di mercato in quella che si avviava ad essere la posizione privilegiata per cavalcare lo sviluppo di Internet.
Gli standard principali utilizzati nell’architettura software del Web sono sostanzialmente tre:
L'indirizzamento URL. Ogni risorsa accessibile via Web ha un indirizzo URL di riferimento. Tale indirizzo è costituito da tre parti:
Un URL assume dunque la forma seguente
metodoaccesso://nomehost:porta/nomeoggetto
anche se il numero della porta viene solitamente omesso in quanto il protocollo scelto sottintende quale porta utilizzare. Ad esempio http://www.apav.it/mascella/indice.html rappresenta l’URL della pagina indice di queste dispense “indice.html”, che dunque viene recuperata con il metodo http, dall’host www.apav.it, ed ha nome complessivo /mascella/indice.html , ovvero è contenuta nella directory mascella, mentre il numero di porta omesso è di default 80.
Esistono alcune regole per completare un URL non specificato interamente dall'utente: se manca il nome della directory, si assume che la directory sia la stessa della pagina precedente; se manca il nome del file si restituisce un file prefissato all’interno della directory (“index.html”, “default.html” oppure “welcome.html”), e così via.
Il linguaggio HTML. In generale una pagina web è composta da una pagina testuale formattata con il linguaggio HTML e da oggetti referenziati nella pagina testuale stessa. Questo linguaggio è una specializzazione del linguaggio SGML (Standard Generalized Markup Language) definito come standard ISO, ed è stato progettato appositamente per il suo uso sul Web.
In altre parole, mentre in un normale editor di testo (la formattazione del testo è nascosta all’utente (secondo la filosofia WYSIWYG, What You See Is What You Get), nel testo di una pagina web, detto anche pagina HTML, i comandi per la formattazione (tag) sono inseriti in modo esplicito. E’ il browser, in fase di lettura, a interpretare i comandi della pagina ed a visualizzarla sul monitor, tenendo comunque conto di altre caratteristiche di tipo locale (dimensioni della finestra, risoluzione dello schermo, profondità del colore, ecc.).
Esempio: per visualizzare la frase
“… I’m not afraid of anything in this world …”
il testo HTML deve essere
“…I’m not <B>afraid</B> of <I>anything</I> in this world …”.
Il protocollo HTTP. Il protocollo HTTP è il protocollo di livello Applicazione che permette di gestire il sistema d’informazione ipermediale e distribuito del web, occupandosi nello specifico del dialogo tra client e server web. E’ un protocollo senza memoria (stateless) in quanto ogni interazione tra client e server si svolge indipendentemente da eventuali “dialoghi” precedenti, e d’altro canto non è previsto un livello di sessione che li ricordi. Questa struttura, per certi versi necessaria, permette di ricercare e recuperare un’informazione in maniera veloce, saltando rapidamente da un server all’altro attraverso i collegamenti ipertestuali.
Ogni singola interazione tra client e server si svolge con la seguente procedura:
Da osservare, inoltre, che HTTP è un protocollo ASCII, cioè i messaggi scambiati tra client e server sono costituiti da sequenze di caratteri ASCII. Pertanto, per spedire i dati di vario genere che costituiscono una pagina web, viene di nuovo usato il protocollo MIME, e dunque anche tra le informazioni scambiate sulla natura dei dati, vanno comunicati i tipi di formato utilizzati.
La procedura di utilizzo appena descritta assegna al protocollo HTTP una semplicità di gestione molto alta, in quanto ogni interazione si svolge prevedendo esclusivamente una richiesta ed una risposta (una conversazione più lunga si articola con una serie di contatti tra loro indipendenti) ma anche le tipologie di informazioni che si possono gestire sono facilmente estendibili attraverso la definizione di nuovi tipi di formato MIME.
Un ruolo molto importante è ricoperto da alcuni agenti software intermediari:
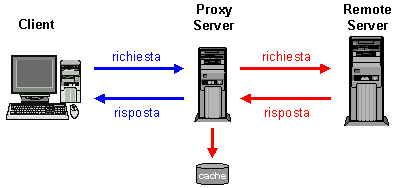
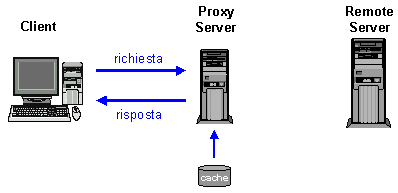
proxy server, un programma che ha il compito di agire sia come server che come client, con il proposito di eseguire richieste per conto di altri client. La procedura tipica è la seguente: il client inoltra la richiesta al proxy, il quale provvede ad inviarla al server; quest’ultimo, esaminata la richiesta, invia la risposta al proxy che provvede ad inoltrarla al client richiedente. Un proxy può essere “trasparente” se non modifica le richieste e le risposte che lo attraversano, è invece “non-trasparente” se le modifica (allo scopo di ottenere informazioni o servizi aggiuntivi). I proxy server generalmente supportano una memoria cache locale, che memorizza le risposte ricevute dai server, al fine di ridurre il tempo di risposta ed il consumo di banda di rete per richieste future equivalenti (in realtà ogni client o server può includere una cache). L’idea alla base del caching è semplice: il documento ricevuto in un file locale viene archiviato per usarlo in futuro, senza il bisogno di connettersi ancora al server remoto nel momento in cui quel documento sarà nuovamente richiesto. L’idea, tra l’altro, è implementata in un’ampia varietà di architetture e configurazioni delle reti; ad esempio esistono delle memorie proxy nelle gerarchie nazionali che consentono di risparmiare sulla larghezza di banda transoceanica.
|
Caching Proxy: il documento richiesto
|
|
|
Se una versione aggiornata |
|
gateway, un server che agisce per conto di un altro server ricevendo richieste come se fosse il server originario per la risorsa richiesta, con lo stesso client che può non essere a conoscenza che sta comunicando con un gateway. L’interfaccia standard con la quale si definiscono alcuni aspetti della comunicazione tra server web e programma gateway specifico è nota con il nome CGI (Common Gateway Interface). Un tipico utilizzo del gateway si ha sui cosiddetti motori di ricerca, siti che offrono la possibilità di ricercare informazioni sull’intera rete Internet. In generale questi si compongono di: un robot di ricerca, per esplorare il web in maniera automatica alla ricerca di informazioni sui documenti on line; un database, per conservare le informazioni trovate; un’interfaccia CGI, tra il Web e il programma di gestione del database.
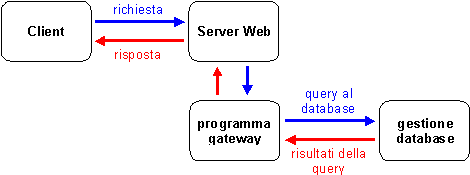
Ulteriori estensioni del Web sono rappresentate dall’introduzione di alcune
funzionalità, sulla scia dei server gateway, e di forme di interattività
superiore alla semplice navigazione tra le pagine con elaborazioni compiute in
locale dal client. In questo ambito spicca l’utilizzo di alcuni linguaggi che
permettono di avere una rapida interazione con la pagina web:
- Javascript, per la definizione di computazioni compiute dal client
attraverso del codice (script) inserito direttamente nella pagina web;
- Java, per la definizione di computazioni effettuate dal client
attraverso file eseguibili (applet); questi, associati a collegamenti
della pagina web, sono trasmessi al server al client assieme alla pagina stessa,
e vengono pertanto eseguiti dal client in autonomia.
La piattaforma di calcolo basata su Java è formata da: il linguaggio Java, un compilatore dal linguaggio al codice eseguibile (bytecode), un interprete del codice eseguibile ovvero la Java Virtual Machine (JVM).
Il protocollo FTP (File Transfer Protocol), che fino ai primi anni ’90 era la maggiore sorgente dei pacchetti che circolavano su Internet, è utilizzato per il trasferimento di file, binari o di testo, tra due computer collegati alla rete. Il suo funzionamento è basato sulla tecnologia client/server: un client FTP richiede un trasferimento di dati, un server FTP risponde alla richiesta.
A differenza del protocollo HTTP, centrato sul trasferimento e sulla visualizzazione delle pagine e delle immagini contenute, il protocollo FTP permette di entrare nelle directories del computer remoto, esattamente come se fosse in locale, con possibilità operative dipendenti dal tipo di accesso. I tipi di accesso FTP sostanzialmente due:
autenticato, in cui l’utente ottiene l’accesso attraverso un processo di autenticazione, che si esplica fornendo al server i propri dati (username, password). In questo all’utente viene concessa la possibilità di compiere tutte quelle operazioni che normalmente si compiono sul disco locale, quali, ad esempio, la copia, la cancellazione o lo spostamento dei files. E’ inoltre possibile trasferire i files in entrambe le direzioni, per cui si possono avere due tipi di procedure:
download, per il trasferimento di files dalla macchina server alla macchina client;
upload, per il trasferimento di files dalla macchina client alla macchina server;
anonimo, in cui ciascun utente può accedere liberamente all’archivio “pubblico”. Con questa modalità l’insieme delle operazioni eseguibili è ristretto rispetto a quelle concesse agli utenti autorizzati dal sistema, in particolare è possibile compiere solo operazioni di download.
L’URL per raggiungere un server FTP in maniera anonima è del tipo
ftp://computer/directory
e fornisce l’elenco dei file contenuti nella directory accompagnati da eventuali messaggi predisposti dall’amiministratore del sito. Come altri server, la maggior parte delle implementazioni di FTP consentono l'accesso simultaneo da parte di più client. Per raggiungere un FTP non anonimo vanno invece forniti username e password con la sintassi usename:password@, ovvero
ftp://username:password@computer/directory
Il servizio di trasferimento dei dati avviene secondo il paradigma seguente, che implica la creazione di due connessioni TCP:
il client FTP inizia una connessione di controllo, che avviene attraverso il protocollo Telnet, eventualmente autentica il proprio accesso (login), ed invia i comandi FTP per visualizzare le directory, trasferire i files, nonché fornire i parametri da utilizzare per il trasferimento, ecc.;
il server FTP crea una connessione dati sulla quale invia e/o riceve i dati richiesti, a seconda della richiesta ricevuta. Per ogni trasferimento, comunicato attraverso la connessione di controllo, il server crea una nuova connessione dati in accordo con i parametri specificati.
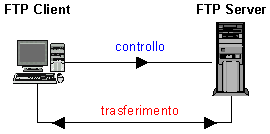
Il protocollo richiede che la connessione di controllo rimanga aperta contestualmente al trasferimento dati; mentre le connessioni di trasferimento dei dati ed i relativi processi che ne fanno uso possono essere creati dinamicamente all'occorrenza, la connessione di controllo permane durante un'intera sessione. Una volta che la connessione di controllo scompare, la sessione “FTP” viene terminata ed il software ad entrambe le estremità termina tutti i processi di trasferimento dei dati. In generale è responsabilità dell’utente la chiusura della connessione di controllo quando termina l’uso del servizio FTP, mentre è il server che fornisce il servizio e che può interrompere il trasferimento se viene chiusa la connessione di controllo. Inoltre, mentre le connessioni del server avvengono su porte diverse (di default sono adiacenti: 20 per il controllo, 21 per i dati), le connessioni del client avvengono alla stessa porta.
Una situazione differente si presenta nel caso in cui l’utente intenda trasferire files tra due hosts, nessuno dei quali è locale. In questo caso l’utente crea la connessione di controllo ai due server ed una connessione dati tra i server stessi: in questo modo le informazioni di controllo sono passati all’utente, mentre i dati sono trasferiti tra i due processi di trasferimento dati dei server.
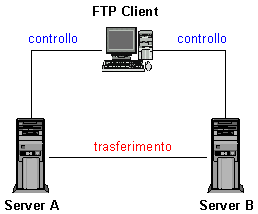
Molto utili sono inoltre i server mirror che contengono una copia di tutti i file (o solo di una parte di essi) contenuti in un certo host FTP, e che vengono aggiornati periodicamente. Attraverso tali server è possibile effettuare le operazioni FTP volute senza sovraccaricare di lavoro un'unica macchina, distribuendo fra più macchine, quindi, il traffico complessivo.
Un gruppo di discussione, o newsgroup, può essere pensato come una bacheca virtuale dove ognuno può inserire articoli accessibili alla comunità di utenti della rete. Tali articoli, ed i relativi newsgroup a cui appartengono, formano precise strutture gerarchiche divise in base all’argomento che intendono trattare.
L’insieme dei newsgroup è talvolta designato con il nome di Usenet, che rappresenta uno spazio virtuale di comunicazione, fisicamente costituito da una rete di computers chiamati news servers, dove vengono scambiate le informazioni “postate” in rete dagli utenti. Nei News server vengono raccolti i vari articoli dei diversi gruppi di discussione, in maniera del tutto cooperativa. Difatti un articolo spedito nella rete Usenet, viene collocato su un singolo news server, cioè su una macchina privata di qualche organizzazione (ad esempio il provider) e la sua visibilità ad altri utenti, che invece accedono ad un news server diverso, avviene attraverso lo scambio degli articoli fra i server, ripetuti secondo accordi reciproci.
Di fatto i ng sono molto simili alle mailing lists, ma
presentano alcuni vantaggi relativi all’iscrizione che non è necessaria, alla
conservazione degli articoli che avviene su appositi server e all’accesso, che
può avvenire anche tramite browser web. In generale, comunque, l’accesso al
servizio Usenet può essere di due tipi:
- pubblico, ed in tal caso si parla di News server “pubblico”, in cui
l’accesso è libero e gratuito; a volte ciò implica la non totale affidabilità;
- con sottoscrizione, in cui l’accesso avviene attraverso login e con
la sottoscrizione di un abbonamento al servizio specifico Usenet.
Il protocollo utilizzato sul sistema Usenet è NNTP (Network News Transfer Protocol) che specifica in che maniera effettuare la distribuzione, la ricerca, il recupero e l’invio di articoli usando una trasmissione basata su una connessione affidabile. NNTP è progettato per consentire la comunicazione tra i News Server e per l’accesso attraverso i newsreader (il programma client per l’utente; tra i più comuni: Microsoft Outlook e Free Agent), in modo tale che gli articoli news siano memorizzati in particolari server e ogni utente sia in grado di selezionare solo gli articoli voluti, ma anche di indicizzare, di cross postare e di far scomparire gli articoli dopo un certo periodo.
Un elemento fondamentale di un news server è il feed (nutrimento del server), ovvero la rete di computer con cui esso è collegato e attraverso cui avviene lo scambio reciproco degli articoli. Tale procedura, che avviene seguendo una gerarchia, può essere anche molto lenta, ed è in generale decisa dal particolare amministratore del sistema.
Gli host che si scambiano messaggi utilizzano un meccanismo interattivo per decidere quali
articoli trasmettere, evitando articoli non desiderati o duplicati:
- un host che desidera ricevere o inviare nuovi articoli contatta uno o più
vicini
- l’host (client) chiede quali nuovi articoli sono arrivati in alcuni o in
tutti i newsgroups
- l’altro host (server) invia la lista dei nuovi articoli
- l’host client richiede la trasmissione degli articoli che desidera e che non
ha ancora; inoltre informa l’host server dei nuovi articoli cui è in possesso
- l’host server indica quali sono gli articoli di cui non ha ancora copia e
che desidera
- i due host si inviano gli articoli che hanno rispettivamente richiesto.
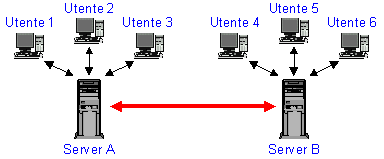
Ogni ng è denominato attraverso una serie parole, separate da punti, che individuano anche la gerarchia sottostante. Ad esempio il gruppo “soc.culture.italian” identifica il gruppo italian (italiano) del sottoinsieme culture (gruppi di discussione sulle culture nazionali) del sottoinsieme soc (gruppi di discussione con argomento sociale) di tutti i ng esistenti. I sottoinsiemi di primo livello più comuni sono:
| alt | discussioni amatoriali |
| comp | sul computer |
| misc | di argomento vario |
| rec | su attività ricreative: sport, spettacolo, hobby, svago, ... |
| news | discussioni su Usenet stessa |
| humanities | discussioni umanistiche: scrittori, musica classica, ... |
| sci | discussioni scientifiche (a livello professionale) |
| bionet | sulla biologia (discussioni professionali) |
| soc | su argomenti sociali; divisi per etnie, lingue, ... |
| talk | dibattiti su argomenti politici, religiosi, d'attualità, ... |
| biz | sul mondo degli affari, investimenti, ... |
| it | in italiano |
Molto importante, soprattutto in questo ambito, è il galateo della rete (o netiquette), costituito da un insieme di regole di comportamento che gli utenti di Internet (e Usenet) hanno il dovere morale di seguire. In buona sostanza esse riguardano la conduzione delle relazioni sociali e il rispetto dell'altrui libertà nella fruizione del servizio.
Il protocollo Telnet fornisce una modalità di comunicazione generale, interattiva, bi-direzionale ed orientata ad 8-bit con la quale è possibile controllare un computer remoto, proprio come se ci si trovasse su un suo terminale. Questa esigenza è nata dal fatto che, prima dell’avvento dei personal computer, le grosse stazioni di lavoro in Unix permettevano a più utenti, e quindi a più terminali, di lavorare contemporaneamente su di essa (oggi si rivela utile, ad esempio, per il controllo di un router a distanza).
L’accesso ad un computer remoto avviene tramite login, per cui bisogna essere utenti riconosciuti; tuttavia sono diffusi anche sistemi nei quali è possibile collegarsi via Telnet con un login pubblicamente noto ed accedere ad un’area “pubblica” nel quale l’amministratore del sistema ha predisposto una serie di programmi o servizi utilizzabili da chiunque (ad esempio per consultare il catalogo di una biblioteca).
Quasi tutti sistemi operativi (Unix, Windows, MacOS, …) oggi forniscono un software telnet, orientato al testo, per connettersi ad una macchina remota e per interagire con il suo sistema operativo. Il funzionamento è in linea di massima il seguente:
i comandi e i dati inseriti dall’utente (da tastiera o da altro programma) sono passati al sistema operativo locale, che li inoltra al processo client telnet
il processo client telnet inoltra i dati attraverso una connessione TCP al processo telnet server del computer remoto
il telnet server remoto invia i comandi e i dati al sistema operativo locale che li inoltra al processo destinatario.
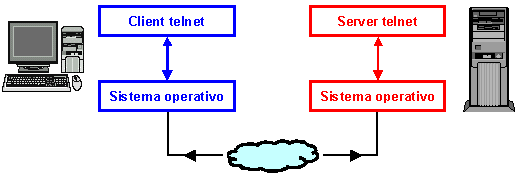
Il protocollo Telnet si basa su tre idee principali:
L’ambiente delle chat oggi fornisce un mezzo di comunicazione col quale si incontrano tante culture, in un sistema che di fatto crea una comunità mondiale virtuale. La comunicazione, essenzialmente asincrona per natura, avviene in tempo reale tra più utenti collegati in rete tramite client apposito o su siti web dedicati e con l’utilizzo quasi esclusivo del testo (ma anche voce e immagini). Ciascun utente è dotato di un nome virtuale, il nickname. Come in ogni comunità, inoltre, ci sono norme che costituiscono linee guida di base per il comportamento e l’interazione fra gli utenti, anche se di fatto non esiste una modalità per creare e sostenere regole e leggi nel mondo virtuale.
I sistemi di comunicazione in tempo reale, nati dall’esigenza di scambiarsi messaggi o comunicare a distanza in tempo reale simulando l’uso del telefono, hanno oggi raggiunto una diffusione planetaria con la possibilità di conversare sugli argomenti più disparati. Inoltre, vista la difficoltà di conversare con tutti contemporaneamente, anche all’interno di uno stesso “canale” di conversazione, i client forniscono, di solito, la possibilità di comunicare privatamente con una o più persone. Tra i client più diffusi figurano, ad esempio: Mirc, ChatRoom, ICQ, Yahoo Messenger, Aol Instant Messenger.
Uno dei protocolli più diffusi, su cui sono basati un gran numero di clients, e certamente il più antico è il protocollo IRC (Internet Relay Chat).
Il protocollo IRC. Sviluppato inizialmente per permettere agli utenti delle BBS (bacheche elettroniche o Bullettin Board System) di “chiacchierare” tra di loro e per permettere conferenze virtuali, oggi supporta una rete mondiale di client e server molto ampia. Oggi IRC è un sistema di teleconferenza, basato sul modello TCP/IP (in generale la porta TCP è la 6667), che ben si adatta ad un uso su macchine e modelli diversi. I processi server costituiscono la spina dorsale di IRC, dei veri e propri punti di connessione per i client e per gli altri server IRC, che effettuano la distribuzione/multiplexing dei messaggi (e altro) all’interno della loro rete (la configurazione topologica è ad albero).
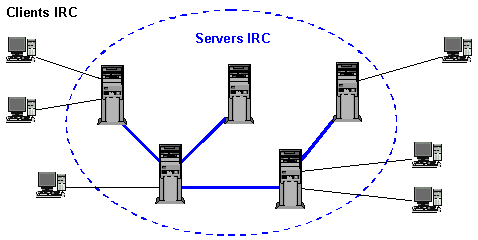
Ogni area tematica avviene generalmente all’interno di un canale, che è un gruppo (con nome) di uno o più client, una vera e propria “piazza virtuale”, il cui funzionamento è simile ai gruppi di discussione (un canale inizia con il primo client, termina con l’ultimo abbandono).
I processi client, che si connettono alla rete attraverso
il proprio server, sono identificati da nickname univoci e possono distinguersi
a seconda del ruolo che svolgono:
- semplici utenti;
- operatori di canale, con poteri di controllo sulla conversazione del proprio
canale;
- operatori IRC, con funzioni di mantenimento generale della rete.
La comunicazione, infine può avvenire con varie modalità:
one-to-one, generalmente effettuata dai clients “privatamente”con il contributo dei soli server che si trovano lungo il percorso della trasmissione, inclusi i server di accesso dei due clients;
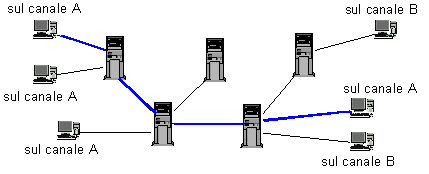
one-to-many, in cui la conversazione avviene tra molti clients, tipicamente da un clients ad una lista o da un clients ad un canale “pubblico”, con la partecipazione di tutti server che hanno utenti destinatari o che si trovano lungo il percorso della trasmissione
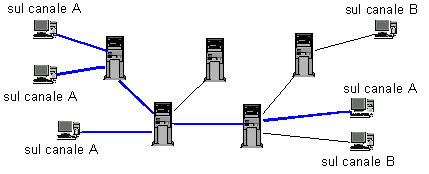
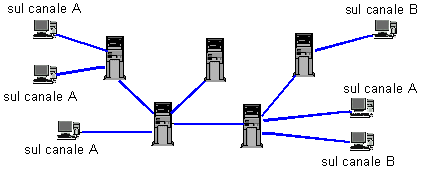
one-to-all, meglio descrivibile come messaggio broadcast, inviato a tutti i clients o servers o entrambi.
Il protocollo SNMP (Simple Network Management Protocol) è uno dei protocolli che non riguardano gli utenti finali, ma soltanto i gestori dell’ambiente di rete. Diventato ormai lo standard de facto per la gestione di reti interconnesse, esso facilita lo scambio delle informazioni di gestione tra dispositivi di rete, permettendo agli amministratori di controllare le performance della rete, di trovare e risolvere problemi, nonché pianificare lo sviluppo della rete.
Una gestione SNMP di rete consiste di tre componenti chiave:

Il modello di gestione della rete implementato dal protocollo SNMP prevede un’architettura manager/agent:
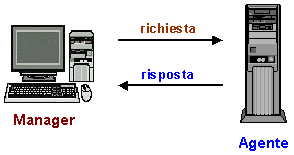
In altre parole il protocollo SNMP permette ai manager e agli agenti di comunicare con il proposito di accedere alle basi di informazioni per la gestione (MIB, Management Information Base) dei dispositivi. E’ chiamato “semplice” perché gli agenti richiedono solo un piccolo modulo software, con l’intento esplicito di minimizzare il numero e la complessità delle funzioni di gestione realizzate dall’agente, mentre affida la maggior parte delle elaborazioni e delle memorizzazioni ai manager.
Il protocollo SNMP funziona principalmente nella modalità connectionless, e in tal caso non offre garanzie sull’affidabilità delle consegne. In generale il protocollo utilizzato al livello trasporto è l’UDP.
Dominio: organizzazione, o parte di un'organizzazione, che possiede e gestisce un sito Internet
Iperoggetto multimediale: detto anche “ipermedia”, dall’inglese “hypermedia”; oggetto caratterizzato da due proprietà: è multimediale, ovvero consente di trasmettere conoscenza usando vari mezzi di comunicazione (quali audio, testi, immagini, filmati, ecc.); è un iperoggetto, ovvero contiene rimandi o collegamenti ad altri iperoggetti che consentono di navigare tra gli stessi in maniera non lineare. Tali collegamenti appaiono in visualizzazione come zone “eccitanti” dell’oggetto, dette zone sensibili.
Ipertesto (hypertext): testo percorso in maniera non lineare. Concetto dovuto a: V. Bush, D. Engelbarth, T. Nelson.